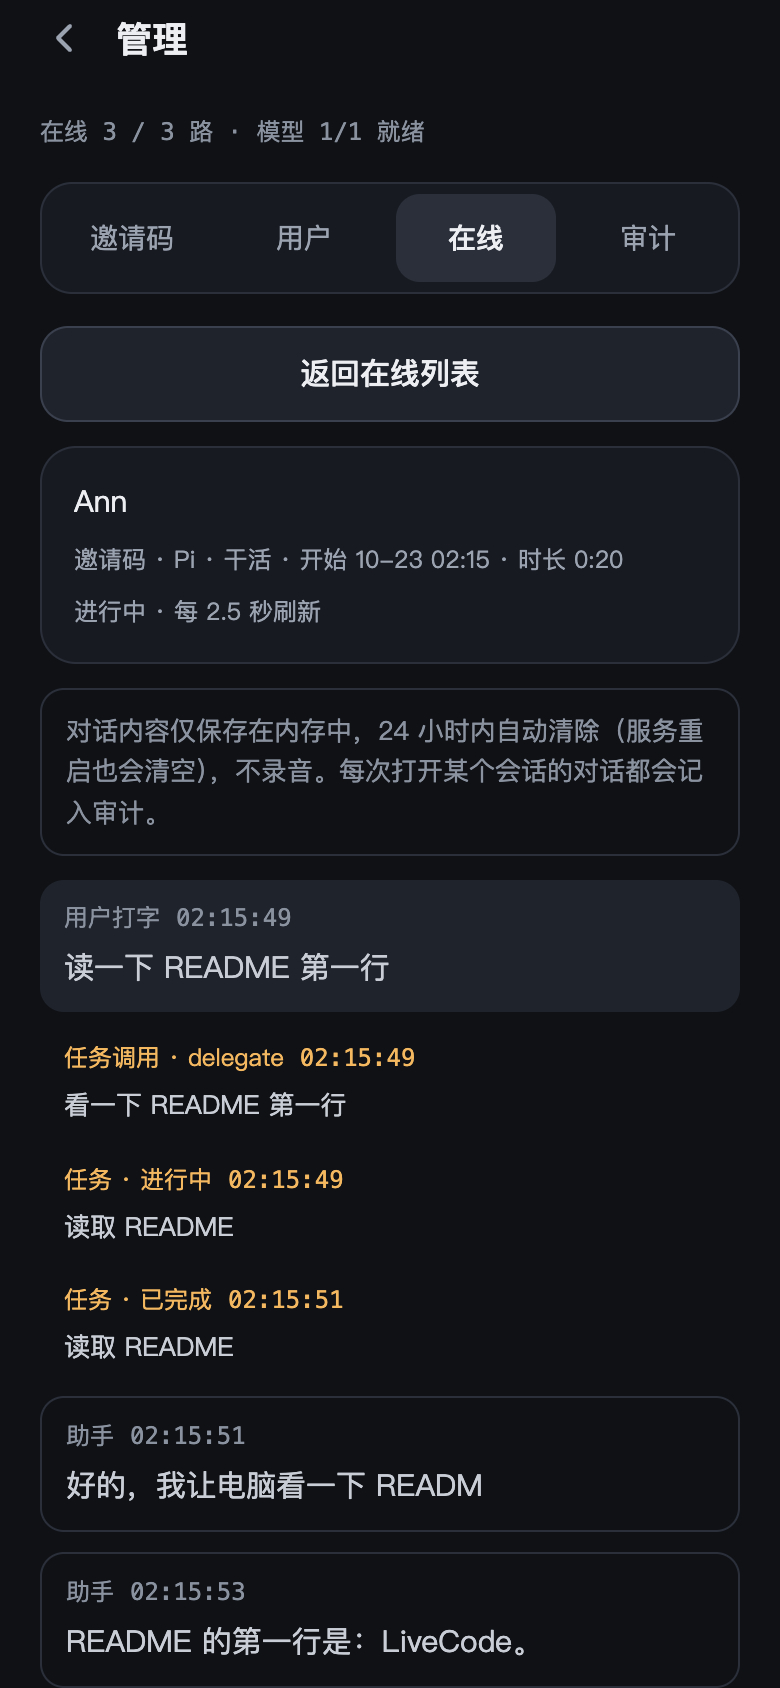
目标说话人模式的比较输入
- 1目标链路
- 2最终句段音频
- 3对比模型
- 4句段下方结果
使用目标说话人链路实际产出的音频,不重新录制整场或把非目标音频送给对比模型。角色模式和目标模式分别回归,避免模式切换后保留错误结果归属。
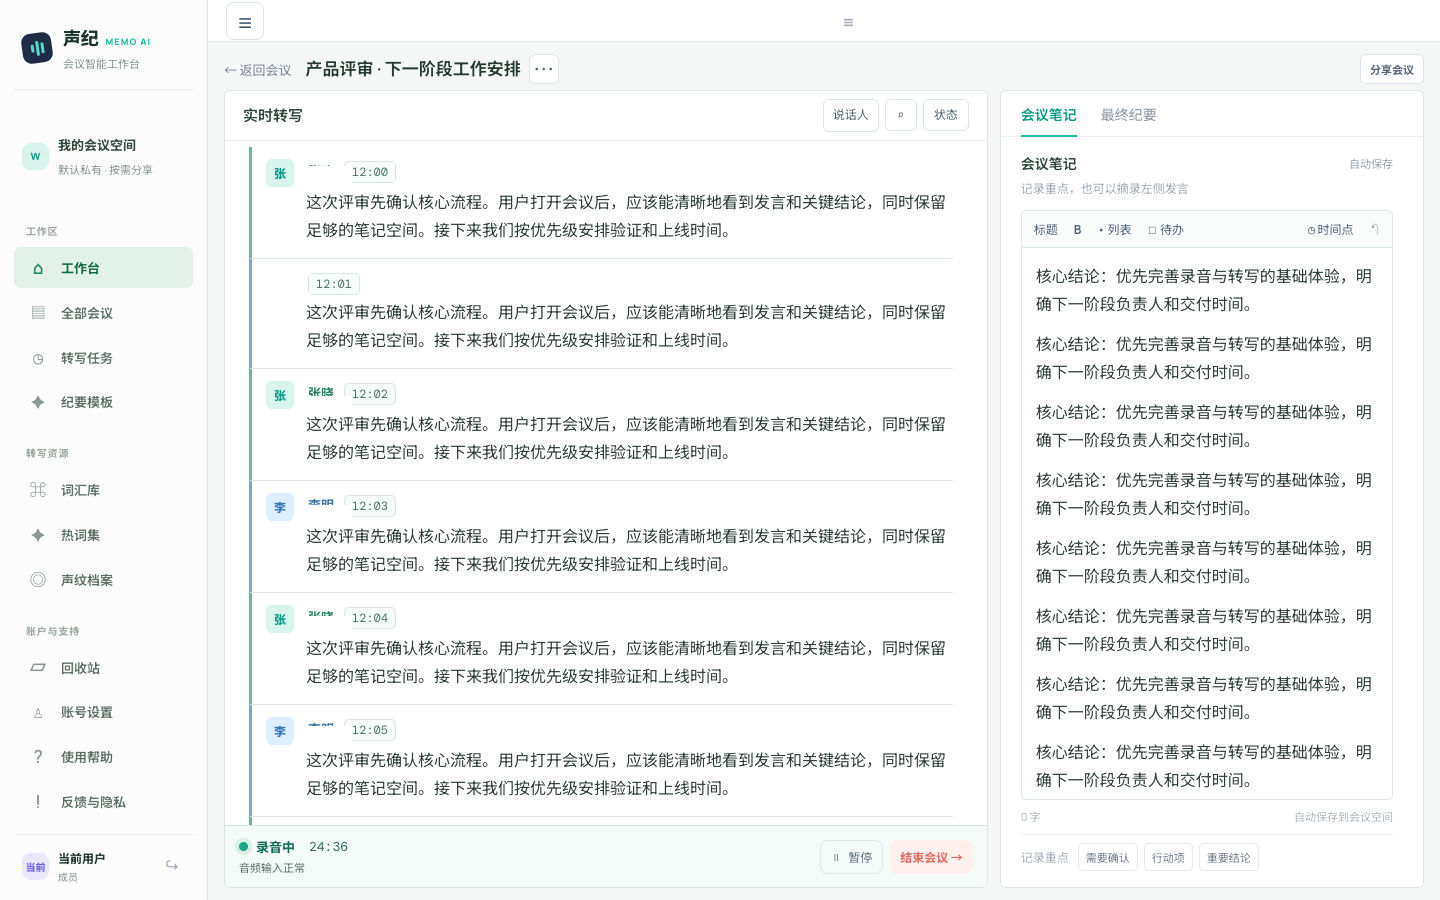
语音模型比较需要尽可能一致的输入,而不同接口的角色、断句和会话语义并不相同。工作台提供实时识别与会议 / 目标说话人模式,允许在句段下追加第三方识别结果,辅助观察转写差异。
使用最终句段范围,而不是对齐两份独立断句文字。
22 组全部到达终态,其中 16 组质量通过;漏首句、重复与重叠讲话 6 组仍待解决。
目标说话人注册只需一段录音,实时页与会议页共用。
Playground 面向语音模型体验与接入调试,包含实时识别、会议角色和目标说话人页面。增加对比 Provider 时,输入音频、切分和角色条件需要保持可解释,否则界面并排显示的文字不能说明差异来自哪里。
页面将第三方识别放在主链路最终句段下方,复用对应音频范围。用户可关闭对比,主识别模式与协议保持既有行为;同一模式的角色结果、时间和对比文本在界面中关联。
后续迭代聚焦阅读与核对:对比结果可以逐句回放,整句可以从原始音频回听;流式文字按固定节奏出现、终稿一次替换;目标说话人注册从三段录音简化为一段 5–8 秒录音。
选择模式、展示逐句结果并持久化对比开关。
确定业务句段、音频范围和主结果。
对同句段调用真实识别接口,将结果追加到主文本下方,可逐句回放。
使用目标说话人链路实际产出的音频,不重新录制整场或把非目标音频送给对比模型。角色模式和目标模式分别回归,避免模式切换后保留错误结果归属。
对比默认关闭,启用后作为逐句附加内容。主识别的角色、终态和文本保持既有协议,第三方输出以独立来源呈现。
前端对比工具和扩展回归由 Agent 编写和执行,失败用例独立复现后再归因。
编写逐句对比回放的前端检查脚本,执行 22 组扩展回归:16 组质量通过,6 组未通过。
6 组失败经独立复现,确认来自模型能力而不是界面问题,结论写进报告后才进入下一轮。
说话人检测的 A/B 结果不用来全局下调阈值,也不借用其他任务正在使用的模型。
对照 Provider 的结果独立展示,不覆盖主识别文本。